
2017 年 Transformer 架构的诞生,开启了大语言模型的黄金时代。依靠自注意力机制,模型能够捕捉文本长距离依赖,推动 NLP、多模态领域爆发式增长。但到 2026 年,行业已经清晰看到 Transformer 的底层瓶颈:全局注意力带来二次方算力开销,处理长时序视频、物理动态场景时成本激增;模型目标是预测下一个 token,本质是拟合海量数据中的统计关联,不具备对物理世界因果、空间、动态规律的原生理解。
在这一背景下,AI 研发主线发生范式转移:不再无限堆叠参数,而是转向预测世界下一个状态(Next-State Prediction),也就是世界模型。2026 上半年全球 AI 实验室调研数据显示,超过 68% 的头部机构将世界模型、新架构、具身智能作为核心研发主线,参数竞赛已经不再是衡量模型能力的核心指标。本文将拆解 2026 年 AI 五大前沿技术突破,分析它们如何弥补 Transformer 短板,推动 AI 从文本生成走向对现实世界的感知、模拟与自主行动。
 ca95c8da436054097e8cb33cfaf3433.webp
一、架构革新:MoE 混合专家 + 状态空间模型(SSM),替代稠密 Transformer 的主流新底座
Transformer 稠密架构的痛点,在长序列任务下被持续放大。序列长度翻倍,算力开销近似四倍增长,处理视频、传感器时序数据时,推理成本居高不下。2026 年最大的底层架构突破,就是 MoE 混合专家与状态空间模型 SSM(Mamba 系列)的融合方案,不再用单一稠密网络处理全部输入。
MoE 架构将模型拆分为大量专家子网络,通过路由机制,每次输入只激活少量专家参与计算,在保持超大模型容量的同时,大幅降低单次推理算力开销。2026 年开源的多款世界模型底座,普遍采用 MoE+DiT 的混合架构,总参数可达数百 B,但单次激活参数仅几十 B,推理成本相比同规模稠密 Transformer 下降 60% 以上。
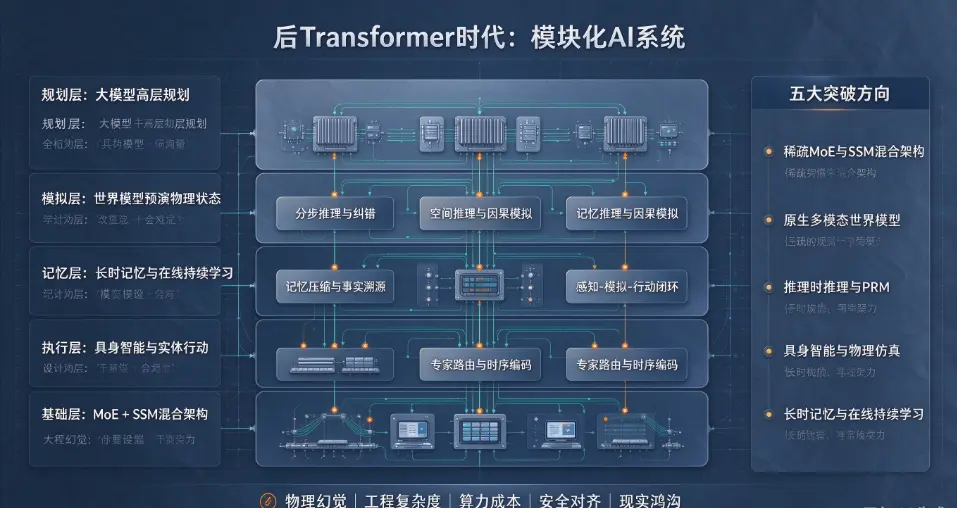
而状态空间模型 SSM 擅长高效处理无限长时序数据流,计算复杂度线性增长,天然适配传感器信号、连续视频帧这类连续物理时序数据。在 2026 的工程实践中,行业形成 “分工式架构”:Transformer 负责高层逻辑、语言推理;SSM 负责连续时序信号编码;MoE 路由动态调度不同模块。Transformer 不再是包揽一切的基础架构,而是模块化系统中的一个子组件。
但该架构也存在短板:MoE 路由容易出现负载不均衡,部分专家被过度调用,带来推理稳定性问题;SSM 在复杂逻辑推理任务上,性能弱于 Transformer。当前行业共识是,新架构不是完全淘汰 Transformer,而是构建混合模块化基座,扬长避短。
二、原生多模态世界模型:从生成像素,转向模拟物理世界动态规律
这是 2026 年 AI 最核心的范式跃迁。传统多模态模型,大多是文本、图像、视频编码器简单拼接,属于 “后融合” 方案,模型只能看懂静态画面,难以理解物体重力、碰撞、摩擦、因果时序。而原生多模态世界模型,在预训练阶段就将文本、图像、音频、深度、物理时序数据统一表征,训练目标从 “预测下一个 token” 升级为预测环境下一个物理状态。
2026 年国内外多个实验室发布世界模型版本,如智源悟界 Physis、英伟达 Cosmos3、蚂蚁灵波 LingBot-World 2.0,在 Physics-IQ 物理合理性评测中持续刷新成绩。这类模型可以在数字空间模拟物体运动、形变、流体变化,提前预判动作带来的环境变化,具备 “在脑海中推演物理实验” 的能力。实测数据显示,原生世界模型在空间推理、因果物理任务上,相比传统拼接式多模态模型任务正确率提升 47%。
世界模型的核心价值,不只用于视频生成。它能够为机器人、数字孪生、工业仿真生成低成本合成训练数据,弥补真实世界采集数据成本高、危险场景数据稀缺的痛点。但当前世界模型仍存在局限:复杂多物体交互、不规则材质(柔性物体、液体)模拟依然容易失真;大规模高保真物理仿真推理成本依然很高,端侧落地难度较大。
三、推理时推理与过程奖励模型(PRM):让 AI 学会边思考边纠错,解决深度推理短板
传统 Transformer 大模型,是一次性输出 token,思考过程隐式隐藏在权重之中,遇到复杂数学、规划、逻辑任务容易一步错、步步错。2026 年,推理时推理(Inference-Time Reasoning)和过程奖励模型 PRM 大规模落地,成为提升模型深度推理能力的关键技术。
简单来说,该技术允许模型在推理阶段,分步拆解问题,生成中间思考步骤,PRM 对每一步中间结果打分校验,一旦发现逻辑错误,模型自动回溯、重新推导,而不是仅对最终答案做奖励。2026 上半年公开评测显示,搭载 PRM 的模型在复杂数学、多步骤规划任务,相比传统 RLHF 模型,解题准确率提升 35% 以上。
这项技术对于 AI 智能体至关重要。自主智能体执行长任务时,需要分步规划、验证、纠错。推理时推理弥补了传统 Transformer “一次性生成” 的缺陷,让 AI 拥有分步思考、自我校验的能力。工程落地层面,代价是推理 token 消耗上升,行业正在通过动态停止、精简中间推理步骤,平衡推理质量与成本。
四、具身智能闭环:世界模型 + 实体执行器,打通感知 - 模拟 - 行动全链路
2026 年,具身智能从实验室 Demo 走向工业场景试点,核心驱动力就是世界模型。单纯大模型是 “无实体大脑”,只能被动输出文本;具身智能则将世界模型作为数字模拟器,接收摄像头、力传感器的物理感知数据,在内部模拟不同动作带来的结果,选择最优动作下发给机器人执行器,再通过传感器反馈闭环迭代。
蚂蚁灵波 2026 年开源的 LingBot-Video,专门面向机器人操作场景构建,训练数据包含 7 万小时机器人第一视角交互数据,在机器人操作基准 RBench 取得 SOTA 成绩。这类模型可以完成灵巧抓取、物体摆放、环境探索等任务,不再局限于数字空间。
从技术链路看,具身智能是世界模型的终极落地场景之一,但挑战同样突出。真实世界存在大量噪声、不确定性,数字仿真和真实环境存在 “现实鸿沟(reality gap)”,仿真中可行的动作,在实体机器人上很容易失效。2026 年行业的解决方案,是采用域自适应、少量真实世界微调,不断缩小仿真与现实的差距。
五、长时记忆与在线持续学习:突破上下文窗口,模型越用越进化
传统 Transformer 存在致命缺陷:上下文窗口有限,模型无法跨会话长期记忆知识;模型训练完成后权重固定,部署之后不会自主学习新知识。2026 年,长时记忆模块与在线持续学习技术成熟,打破这一壁垒。
这套技术包含向量记忆库、记忆压缩、记忆筛选与遗忘机制。模型交互过程中,把重要信息写入外部记忆,区分短期上下文和长期记忆;同时引入在线学习,在部署阶段,从交互数据中持续提炼知识,不会覆盖原有基础能力,同时规避灾难性遗忘。2026 年实测数据表明,搭载长时记忆模块的 Agent,跨会话长任务完成率提升 52%,长文档多轮项目场景效果提升显著。
在线持续学习不等于无限制学习,最大风险是数据污染、记忆篡改。因此行业普遍引入记忆校验、事实溯源、记忆审计机制,区分可靠信息与噪声,防止虚假信息长期沉淀在模型记忆中。
技术演进的挑战与产业启示
五大技术方向共同构成后 Transformer 时代 AI 的技术底座,但行业仍面临多重约束。第一,世界模型的物理保真度不足,复杂场景因果推理仍然会出现幻觉;第二,新架构工程复杂度大幅提升,混合模型、MoE 路由、记忆系统的部署、调优门槛远高于传统 Transformer;第三,算力成本,高保真世界模型仿真、推理时推理,会带来显著算力开销;第四,安全风险,具备世界模拟、自主规划能力的智能体,一旦对齐不足,可能产生不可预期的行为。
产业层面,2026 年的趋势非常清晰:Transformer 不会消失,而是作为模块化组件继续使用;AI 竞争重心从文字问答,转向环境感知、物理仿真、自主规划。AI 能力评价标准,不再只看文本评测,而是物理推理、机器人操作、长周期自主任务等现实世界任务。
结语
从 2017 年 Transformer 诞生,到 2026 年世界模型成为行业共识,人工智能完成一次底层范式切换:从学习语言文本的统计关联,走向学习现实世界运行规律。MoE 与 SSM 混合架构解决算力瓶颈,原生世界模型建立物理认知,推理时推理赋予分步思考能力,具身智能打通虚实交互,长时记忆实现持续进化,这五大方向共同定义未来几年 AI 的技术主线。
但必须客观认识,当前世界模型仍处于早期阶段,距离真正理解世界还有很长距离。未来的 AI 不是单一巨型模型,而是一套模块化系统:由世界模型做环境模拟,大模型负责高层规划,记忆模块存储长期知识,执行模块对接物理或数字环境。这套新体系,将推动 AI 从内容生成工具,逐步进化为能够自主探索、规划、行动的智能系统。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表