
算力基础设施的定义正在发生根本性变化。过去行业讨论算力,大多聚焦 GPU 集群、服务器、机房供电;进入 2026 年,算力基础设施已经演变为算力、存力、运力、模型生态一体化的综合系统。AI 智能体、端侧大模型爆发带来海量数据吞吐需求,存储不再是算力的附属配件,而开源模型平台则成为算力硬件落地的流量入口。长鑫 LPDDR6 量产、英伟达 129 亿美元收购 Hugging Face,一硬一软两大标志性事件,恰好代表两条完全不同的产业突围路线,共同推动全球算力基础设施格局重构。
一、硬件底层突破:长鑫 LPDDR6 量产,补齐端侧 AI 存力短板
2026 年 8 月底,长鑫存储正式官宣自主研发 LPDDR6 实现量产,9 月完成商用落地,搭载于小米 18 Fold 折叠旗舰机型,这也是全球 LPDDR6 产品首次在旗舰终端实现商用交付,打破三星、SK 海力士长期垄断高端移动 DRAM 的局面。从参数指标来看,长鑫 LPDDR6 单颗容量 16GB,最高传输速率可达 12800Mbps,对比上一代 LPDDR5X,带宽提升 60%,功耗降低约 20%,完全符合 JEDEC 官方 LPDDR6 国际标准,同时适配移动端、边缘 AI 终端、车载计算等多场景算力需求。
很多人会把 LPDDR6 简单理解为手机内存升级,但放在算力基础设施的视角,它的价值远不止消费电子。2026 年端侧大模型、本地 AI 智能体快速普及,终端设备需要在本地完成模型推理、多模态数据缓存,对内存带宽、功耗、容量提出严苛要求。以往高端低功耗 DRAM 长期被海外厂商把控,一旦供应链出现波动,端侧算力硬件量产会直接受限。长鑫 LPDDR6 量产,意味着国内在低功耗高速存储领域,实现从标准跟随到首发落地的跨越,补齐算力基础设施里 “存力” 这一关键短板。
在算力集群体系中,存力瓶颈长期制约算力释放。无论是云端大模型训练,还是边缘端 AI 推理,内存带宽不足会造成 GPU 算力空转,也就是行业常说的 “算力饥饿”。LPDDR6 这类高速低功耗 DRAM,除手机之外,还可用于边缘智算盒子、车载域控制器、工业边缘网关,支撑分布式边缘算力网络建设。不过客观来看,长鑫当前突破集中在移动低功耗存储赛道,面向数据中心的大容量高性能存储芯片,仍然还有较长迭代周期,国产化替代是渐进式过程,而非一步到位。
 43f611379bda88446d70911ec7742d0.webp
二、软件生态并购:英伟达 129 亿美元收购 Hugging Face,锁定算力入口
2026 年 9 月,英伟达官宣以 129.3 亿美元收购 Hugging Face,这笔交易是英伟达史上规模最大收购案,预计 2027 上半年完成交割,需要通过多国反垄断审查。Hugging Face 被称为 AI 领域的 GitHub,平台沉淀 1800 万开发者,托管超过 300 万个开源模型、50 万数据集、百万级 AI 应用,20 多万企业在平台完成模型选型、微调、部署全流程工作。
市场表层解读认为,英伟达只是买下一个开源模型网站,但产业底层逻辑完全不同。英伟达过去的核心壁垒是 GPU 硬件 + CUDA 软件栈,依靠硬件性能与开发工具生态占据全球 AI 加速卡九成左右市场份额。但 2026 年行业出现新变化:头部云厂商、科技企业纷纷自研 AI 芯片,客户开始尝试脱离 CUDA 生态,直接在自研芯片上部署开源模型。如果模型部署入口被其他平台掌握,英伟达 GPU 的市场份额会面临长期侵蚀。
收购 Hugging Face,本质是英伟达把算力的 “硬件层” 延伸到 “模型分发、开发者工作流层”。有意思的是,英伟达承诺收购完成后,Hugging Face 保持平台中立,开发者依旧可以在平台选择其他品牌芯片、云厂商。这并不是单纯的让利,而是更高级的生态策略:占据模型开发入口,无论开发者最后选用哪款硬件,模型的微调、评估、部署流程都经过 Hugging Face 平台,间接强化英伟达在整个 AI 工程链路的话语权,把 CUDA 生态优势嵌入模型开发全流程。
这笔并购也带来争议。开源社区担忧,巨头收购会削弱平台中立性,开源模型生态的多元化会受到冲击;监管机构重点审查交易是否会造成算力与模型市场的联合垄断。在算力基础设施的新竞争时代,硬件不再是唯一护城河,开发者、模型、数据集构成的软件生态,正在变成算力基础设施不可分割的一部分。
三、两大事件对照:算力基础设施的 “硬件自主” 与 “生态卡位” 两条路线
将长鑫 LPDDR6 量产与英伟达收购 Hugging Face 放在一起对比,能清晰看见 2026 全球算力产业两条差异化的演进路径。
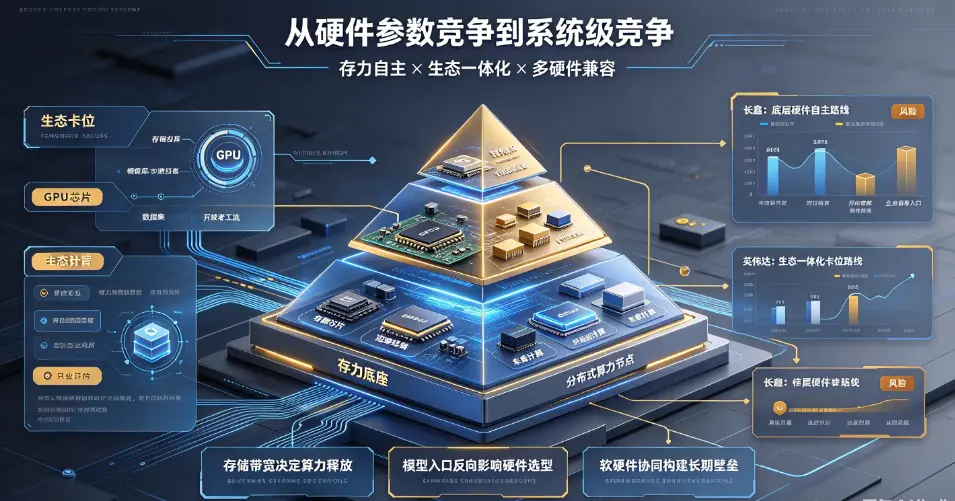
长鑫代表底层硬件自主路线,聚焦存储这类算力基础设施的基础元器件,解决供应链安全、存力自主可控问题。算力系统由计算、存储、网络共同构成,长期以来国内算力建设更多投入 GPU、服务器层面,存储芯片的短板容易被忽略。而 AI 大模型、多模态智能体场景下,存储带宽直接决定算力的实际利用率,没有自主可控的高速存储,再强大的算力集群也会存在供应链隐患。这条路线的特点是周期长、投入巨大,技术迭代循序渐进,价值体现在产业安全与长期供应链稳定。
英伟达收购 Hugging Face 代表生态一体化卡位路线,从硬件向上游模型与开发者社区延伸,打通 “芯片 - 框架 - 模型 - 应用” 完整链路。过去算力基础设施是卖硬件产品;未来算力基础设施变成一套完整开发体系,硬件只是整套体系里的一个组件。谁掌握模型分发、开发者工作流平台,谁就能定义模型部署标准,反向影响硬件选型,掌握产业链话语权。
两大事件共同印证同一个行业判断:单纯比拼单一硬件参数的时代已经结束,算力竞争进入系统级竞争。算力、存力、软件生态、开发者社区需要协同发展,只强一环很难构建长期壁垒。
四、产业现存挑战与中长期格局预判
2026 算力基础设施产业机遇背后,依然存在多重结构性挑战。
从存储硬件端看,长鑫实现 LPDDR6 首发量产,是国产 DRAM 里程碑,但高端存储芯片的良率、成本、全系列产品矩阵搭建,还需要持续打磨。全球存储市场周期性价格波动,也会对新产线的盈利与扩产计划带来压力。同时,数据中心级 HBM 高带宽内存,依旧是国产存储的主要难点,而 HBM 正是大模型训练服务器的核心存储部件。
从 AI 软件生态层面,英伟达收购 Hugging Face 面临全球多国反垄断审查,交易存在不确定性。开源社区的信任维护、平台中立性的维持,将成为收购完成后最大考验。一旦平台中立性受损,开发者会快速迁移至其他开源模型社区,巨额收购的战略价值将会大打折扣。
放眼全球,算力基础设施正在形成分层格局。底层存储、芯片等基础硬件,多国加速自主化布局;模型、开发框架、部署工具这类上层生态,则进入巨头争夺的主战场。未来算力基础设施不再是简单的服务器堆叠,而是硬件、存储、网络、模型工具链融合的一体化系统。
结语
长鑫 LPDDR6 量产和英伟达收购 Hugging Face,一存一算、一硬一软,是 2026 年全球算力基础设施产业最具代表性的两个样本。长鑫的突破,证明国内在高端存储硬件领域具备追赶甚至局部领跑的能力,夯实算力基础设施的存力底座;英伟达收购 Hugging Face,则揭示算力产业竞争重心转移,软件生态、开发者社区成为算力基础设施的核心组成部分。
算力基础设施的博弈,不是单点技术竞赛,而是全产业链体系能力的长期比拼。对于国内算力产业而言,既要持续推进存储、芯片等底层硬件自主攻关,补齐存力短板;同时也要重视模型开发、开源社区、AI 工程工具等上层生态建设,构建属于自己的软硬件协同算力体系,在全球算力格局重构的周期里,找到可持续的产业定位。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表