
2026 年,AI 产业已经形成学术论文、开源模型、产业落地数据并行爆发的态势。ICLR、ICML、NeurIPS、CVPR 等顶会每年接收论文数量持续走高,arXiv 预印本每日新增 AI 相关论文数百篇,同时大量产业机构、云厂商、模型实验室持续发布行业实测数据。很多从业者的痛点不再是找不到资料,而是信息源繁杂、质量参差不齐,大量预印本尚未经过同行评审,行业报告充斥二手转述数据,很难快速筛选出可信、高质量的前沿信息。
一份完整的 AI 前沿研究体系,需要同时具备学术底层原理、可复现代码、实测基准、产业落地数据四层信息。本文按照从学术顶会到产业调研的顺序,整理 2026 年最新可用资源渠道,同时给出资源筛选、信息核验的实战方法,帮助研究者搭建稳定、高效的前沿研究信息栈。
 d8d0f86b682d1caac070e7be72aaeb0.webp
一、顶会论文与预印本:学术前沿第一手来源
AI 领域和传统学科不同,重大成果通常先以预印本形式发布,再提交顶会评审。2026 年 AI 核心顶会分为四大方向:通用机器学习方向 NeurIPS、ICML、ICLR;计算机视觉 CVPR、ICCV、ECCV;自然语言处理 ACL、EMNLP、COLM;系统与 ML 工程 MLSys、CoRL(机器人 / 具身智能)。
OpenReview 是 ICLR、NeurIPS、MLSys 等会议的核心评审平台,在论文正式录用阶段就可以看到审稿意见、作者回复,能够提前理解论文争议点,是 2026 年科研人员最常用的顶会原生渠道。CV 系列会议论文集在 CVF 官网开放免费下载;NLP 领域论文可以在 ACL Anthology 免费获取全文,不需要付费数据库权限。
预印本平台 arXiv 仍然是全球 AI 成果首发阵地,2026 年统计数据显示 [cs.AI](cs.AI)、cs.LG、[cs.CL](cs.CL)、[cs.CV](cs.CV) 四个分类每日新增论文超过 220 篇。但预印本没有同行评审,存在大量实验设计缺陷、结论夸大的稿件,不能直接等同于可靠结论。配套辅助工具 Hugging Face Papers 每日精选 arXiv 热门论文,附带模型、数据集链接与社区讨论;Papers with Code 自动关联论文、开源代码、基准测试榜单,研究者可以快速验证论文实验是否可复现,是打通 “论文 - 代码” 链路的核心工具。
文献溯源工具 Connected Papers、Semantic Scholar 可以根据一篇核心论文生成文献网络图,快速查找经典奠基文献与后续跟进工作,解决文献调研中容易遗漏相关工作的问题。Paper Digest 则专门针对顶会做论文汇总,自动提取 2026 ICML、ICLR、CVPR 等会议论文核心贡献,适合快速批量浏览会议成果。
检索实操建议:优先使用 OpenReview 查看顶会录用论文,再到 arXiv 下载预印本,最后通过 Papers with Code 核查开源代码。不要只阅读摘要,重点关注实验部分、局限性陈述,规避预印本夸大效果的陷阱。
二、开源代码、基准数据集与模型资源:验证技术真实性
论文结论是否可信,很大程度取决于代码、数据集是否开源。2026 年,开源生态已经成为 AI 研究不可或缺的一环。Hugging Face Hub 不仅存放模型权重,还配套数据集、评测脚本、推理 Demo,大量 Agent、多模态、具身智能研究直接在此发布。
基准数据集方面,除传统 MMLU、GSM8K 等通用评测集,2026 年涌现大量面向 Agent、物理世界推理、长上下文的新型评测基准。这些基准大多托管在 Hugging Face Datasets、GitHub,很多论文会附带评测脚本。需要注意,基准存在 “刷榜” 现象,模型在公开榜单的高分,不一定代表真实业务场景性能,需要交叉验证多个评测集。
开源代码仓库推荐优先筛选官方仓库,区分作者原生实现与第三方复现。很多第三方复现无法还原论文全部实验条件,容易得出偏差结论。对于企业 AI 工程师,这套资源可以快速复现前沿算法,评估技术落地可行性,减少重复造轮子。
三、产业一手数据渠道:从实验室成果到真实落地指标
学术论文重点关注理论与受控实验,而产业研究需要真实业务数据、算力成本、落地 ROI、客户实测效果。产业数据分为三类:头部实验室技术报告、云厂商白皮书、第三方行业调研。
第一类是大厂实验室一手技术报告。OpenAI、Google DeepMind、Anthropic,以及国内各大模型实验室,会定期发布技术简报、安全报告、模型实测报告。这类报告属于第一手信息,直接披露模型能力、失败案例、推理成本,比媒体转述更加可靠。
第二类是云厂商与算力服务商白皮书。AWS、Azure、阿里云、腾讯云等会发布智算集群、大模型部署、Agent 工程化白皮书,包含真实推理时延、显存占用、算力成本等工程指标,是做落地成本测算的核心数据源。
第三类是第三方产业研究机构。这类报告优势在于横向行业对比,但需要警惕:很多第三方报告数据来源于访谈、二手汇总,存在估算偏差。2026 年行业调研的最佳实践是:以厂商原始白皮书为基准,交叉核对多家第三方报告,不能单一采信一份报告。
此外,技术博客、工程团队公众号、技术社区也是重要补充。很多模型微调、RAG、Agent 落地的工程踩坑经验,不会写成学术论文,只会在技术博客发布,适合工程研究者获取实战经验。
四、行业通讯、播客与社区:跟踪前沿动态,理解行业争议
论文与报告偏向静态成果,而行业通讯、技术社区、专家访谈适合跟踪动态讨论。高质量 AI Newsletter 可以每日筛选 arXiv、顶会、产业新闻,节省大量筛选时间。海外 AI 研究播客、技术论坛,经常邀请论文作者、实验室负责人深度对话,讨论论文背后的失败实验、技术取舍,这些内容不会写进正式论文。
社区渠道需要做好筛选,区分专业讨论与营销软文。很多项目宣传会刻意放大技术效果,混淆 “原型 Demo” 与规模化落地能力,需要结合论文、代码、实测数据交叉验证。
五、搭建标准化研究工作流,规避 2026 年前沿研究常见误区
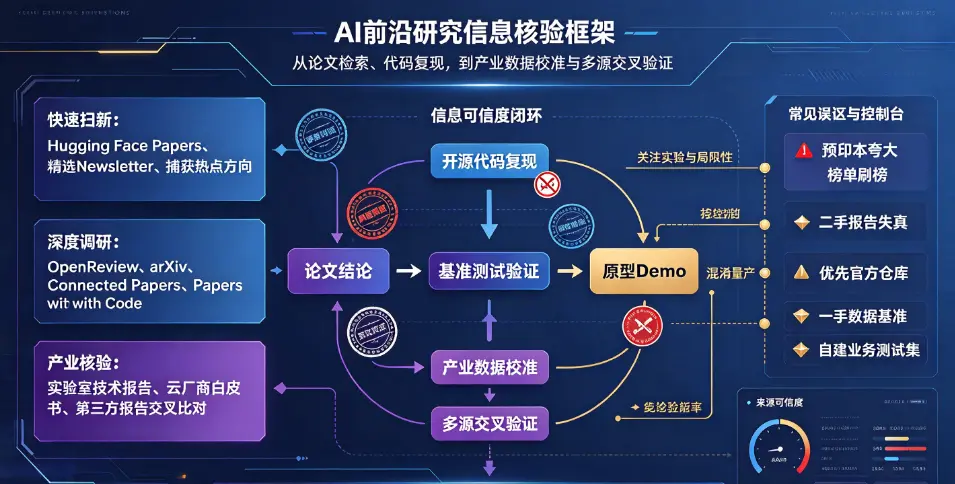
资源再多,没有标准化工作流依然容易被虚假结论误导。推荐一套三层研究工作流:第一层快速扫新,每日浏览 Hugging Face Papers、精选 Newsletter,快速捕获热点方向;第二层深度文献调研,使用 Connected Papers 梳理研究脉络,筛选顶会论文,核查开源代码与基准;第三层产业交叉核验,结合厂商白皮书、实测数据评估商业化潜力。
同时重点警惕四大常见误区。第一,预印本不等于已验证成果,2026 年 arXiv 大量稿件存在实验缺陷,未经同行评审,结论不可直接采信。第二,榜单刷榜问题,模型在公开基准上的性能,存在过拟合评测集风险,必须自建业务测试集验证。第三,二手行业报告失真,部分调研机构数据为估算值,原始一手数据永远优先级更高。第四,混淆技术原型与商业化产品,很多前沿 Agent、世界模型 Demo 仅为实验室原型,距离大规模商用还有巨大工程鸿沟。
另外在资源使用上注意版权与数据安全:商用项目直接使用开源模型、数据集,需要仔细核对开源协议;企业内部机密数据不要上传第三方论文解析工具,避免信息泄露。
六、资源分层选型建议:不同人群资源组合方案
学术科研人员:OpenReview + arXiv + Papers with Code + Semantic Scholar,重点追踪顶会审稿意见、开源实现,梳理研究脉络。
算法 / AI 工程工程师:Hugging Face Hub + 云厂商白皮书 + GitHub 官方仓库,优先关注可部署代码、性能实测指标。
AI 行业分析师:实验室技术报告 + 一手产业白皮书 + 第三方行业报告交叉比对,兼顾学术进展与商业化落地。
总结
2026 年 AI 前沿研究已经进入信息爆炸时代,研究者比拼的不再是能不能找到论文,而是信息筛选、溯源、交叉核验的能力。一套完整的前沿研究资源栈,由顶会论文预印本、开源代码数据集、产业一手报告、专家社区通讯共同组成。学术论文负责理解底层原理,开源代码验证实验可复现性,产业数据评估落地价值,社区讨论补充技术取舍与行业争议。
无论科研还是产业研究,核心原则始终不变:单一来源信息不能作为结论,必须多源交叉验证。掌握这套资源渠道与核验工作流,能够大幅降低信息噪音,持续、稳定地跟踪 AI 前沿技术演进,避开论文夸大、报告失真等常见陷阱。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表