2026 年,大模型技术持续迭代,LLM 应用开发、智能体工程、模型微调岗位需求持续扩张,但自学 AI 的学习者普遍陷入两极困境:一部分人埋头钻研复杂数学推导,迟迟无法动手写代码跑项目;另一部分仅停留在提示词调试,看不懂 Transformer 底层原理,遇到模型幻觉、检索失败、微调 loss 异常等问题无从排查。AI 学习已经不能沿用过去 “先学完整数学,再学机器学习,最后接触大模型” 的老旧顺序,需要建立分层目标、按需补基础、理论与项目并行的全新学习路线。
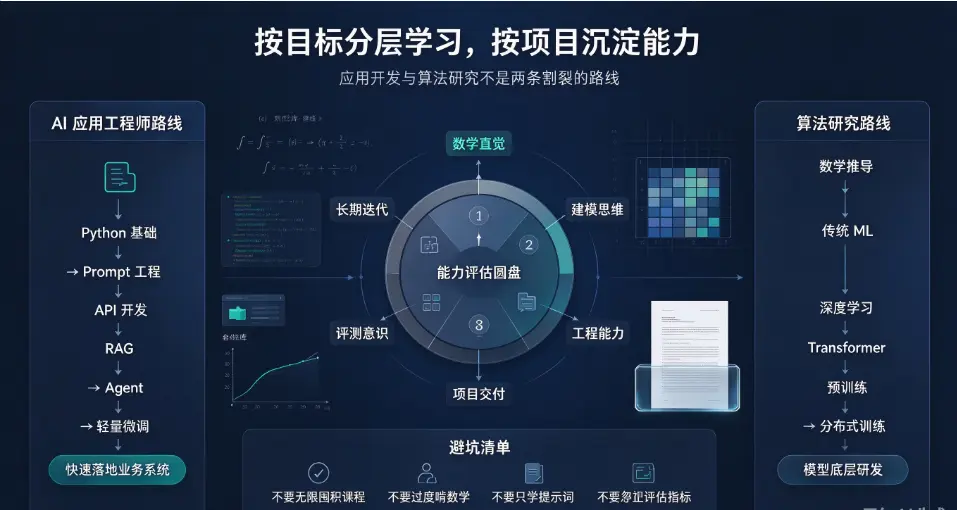
本路线分为三大核心模块:数学基础、机器学习体系、LLM 实战工程,同时区分两条发展分支:AI 应用工程师路线(侧重模型调用、RAG、Agent 开发,数学掌握核心直觉即可),算法研究路线(完整数学推导、模型预训练、分布式训练,需要系统学习凸优化、数值分析)。学习者可根据求职目标灵活调整学习深度,避免无效学习。
 e15b7873e0efb35a1b956844252c6e4.webp
一、数学基础:按需学习,拒绝盲目啃书
数学是大模型的底层骨架,但 2026 年行业共识是:应用开发不需要精通全部高数,掌握 AI 相关核心概念即可。三大核心板块:线性代数、微积分、概率统计,搭配优化理论基础。
线性代数是向量嵌入、注意力机制的根基,重点掌握向量、张量、矩阵乘法、点积、余弦相似度、特征空间、层归一化。理解 QKV 注意力矩阵运算逻辑,看懂 Embedding 如何将文本映射到高维向量空间,这是 RAG 语义检索的底层原理,不需要手动完成复杂矩阵求逆运算。推荐书籍《人工智能大模型数学基础》(北大出版社 2026 新版),配套 Karpathy 免费数学入门课程,适合建立直观认知。
微积分核心掌握导数、偏导数、梯度、链式法则、梯度下降。理解反向传播如何更新模型参数,看懂损失函数下降曲线,能够判断训练是否出现梯度消失、梯度爆炸。概率统计重点学习最大似然估计、交叉熵损失、KL 散度、贝叶斯推断、概率分布,理解大模型文本生成本质是下一个 token 的概率采样,理解幻觉、困惑度 Perplexity 背后的统计逻辑。
如果目标是模型预训练、底层框架研发,需要额外补充凸优化、信息论、数值分析;如果仅做 LLM 应用开发,可跳过复杂推导,优先建立概念直觉,在项目遇到问题时再回头补数学知识点。
配套免费资源:MIT 线性代数公开课、《Mathematics of AI》2026 新版工作坊讲义、B 站《AI 数学极简入门》。
二、机器学习阶段:建立模型思维,打通传统 ML 与深度学习
很多学习者直接跳过机器学习,上手大模型,会出现无法理解过拟合、数据泄露、评估指标、模型泛化能力等核心问题。2026 年的学习逻辑是:传统机器学习帮助建立 “数据 - 特征 - 模型 - 评估” 完整建模思维,深度学习作为桥梁,最终过渡到大模型。
第一阶段经典机器学习:掌握监督学习、无监督学习基础。重点吃透线性回归、逻辑回归、决策树、随机森林、XGBoost,理解分类、回归任务的评价指标(准确率、召回率、F1、AUC),掌握交叉验证、特征工程、数据清洗、处理数据泄露。推荐 scikit-learn 框架,完成销量预测、用户流失预测等小型端到端项目。
第二阶段深度学习基础:学习神经网络基础、激活函数、优化器、正则化。重点理解 CNN、RNN 的优缺点,最终聚焦 Transformer 架构,吃透自注意力、残差连接、位置编码。这是进入 LLM 最重要的门槛。推荐 Andrej Karpathy《Neural Networks: Zero to Hero》,课程代码开源,可复现极简版 Transformer。
实战项目要求:手写简易神经网络,搭建文本分类模型,完成基础数据集训练,学会观察 loss 曲线、定位欠拟合 / 过拟合问题。
配套资源:CMU 10-423 Generative AI(2026 秋季课程,课件公开)、《动手学深度学习》2026 修订版、ML Zoomcamp 免费机器学习训练营。
三、LLM 实战工程:2026 核心落地能力,从 API 调用到微调与 Agent
LLM 工程是整套路线的终点,也是 2026 就业核心能力,学习顺序建议:Prompt 工程 → 向量数据库与 RAG 检索增强 → 函数调用与工具调用 → LoRA/QLoRA 轻量化微调 → 多智能体 Agent 开发与 LLMOps。
提示词与 API 开发:学习结构化输出、Few-shot、思维链 CoT,学会调用国内外开源 / 闭源大模型 API,处理上下文窗口管理,掌握模型输出稳定性控制。推荐微软《Generative AI for Beginners v3》免费课程,21 节实操课,配套 Python 代码。
RAG 检索增强生成:这是工业界落地最多的 LLM 方案。学习文档分块、Embedding 嵌入、混合检索、重排、引用溯源、RAG 评估。掌握 PGVector、Chroma 等向量数据库,搭建私有知识库问答系统。DataTalks.Club 的 LLM Zoomcamp(2026)是行业口碑极高的免费实战课程,10 周项目制学习,最终产出可部署 RAG 系统。
模型轻量化微调:2026 年本地部署门槛持续降低,重点掌握 LoRA、QLoRA、DoRA 高效微调技术,不需要完整预训练。学习数据集清洗、格式转换、训练参数调优、模型合并、量化推理。开源项目推荐 mlabonne/llm-course,全套 Colab 可直接运行,在笔记本 GPU 即可完成 7B 模型微调实验。
Agent 与多智能体开发:学习 LangGraph、AutoGen,构建带记忆、工具调用、任务规划的自主智能体,掌握状态管理、Agent 评估、错误重试。LangChain 官方 LangChain Academy(2026 更新)是首选学习资源,聚焦生产级 Agent 开发模式。
LLMOps 工程化:模型版本管理、评测体系、监控、延迟与成本优化、模型量化、KV 缓存推理加速。这是区分业余爱好者与专业 AI 工程师的关键能力。
推荐实战项目清单(由浅入深):私有文档知识库 RAG、基于工具调用的信息检索 Agent、领域小模型 LoRA 微调、多智能体投研分析系统。
四、学习规划、避坑指南与社区资源推荐
整套路线建议总周期 10~12 个月,每周投入 10 小时。0-2 个月数学 + Python 筑基;3-5 个月机器学习与深度学习;6-10 个月 LLM 工程实战,同步完成至少 2 个可上线项目。
三大高频误区:第一,无限囤积课程,只收藏不写代码;第二,过度深挖数学,迟迟不落地项目;第三,只学提示词,完全不理解底层原理,无法处理生产环境故障。2026 年行业招聘标准,项目经验权重远高于单纯课程证书。
优质社区资源:HuggingFace 论坛、GitHub LLM 开源社区、DataTalks.Club、国内 AI 研究社群。论文阅读推荐从 arxiv 最新 LLM 综述入手,优先读实验设计,不必死磕全部数学证明。
五、路线总结与能力成长预判
2026 年 AI 人才的核心竞争力,是在理解底层原理的前提下,快速落地可用的大模型系统。数学基础提供诊断问题的洞察力,机器学习提供建模与评估思维,LLM 工程将理论转化为产品。两条路线不是割裂的:应用工程师同样需要基础数学,算法研究者也必须具备工程实战能力。
未来两年,岗位竞争会持续加剧,单纯会调用 API 的开发者会逐渐饱和,而懂原理、能做评测、可独立完成 RAG、微调、智能体全链路开发的复合型人才,会持续拥有更多机会。这套路线兼顾理论深度与实战落地,学习者可以根据自身基础动态调整学习节奏,持续迭代项目作品集,完成从零基础到 AI 工程师的成长。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。


评论列表