
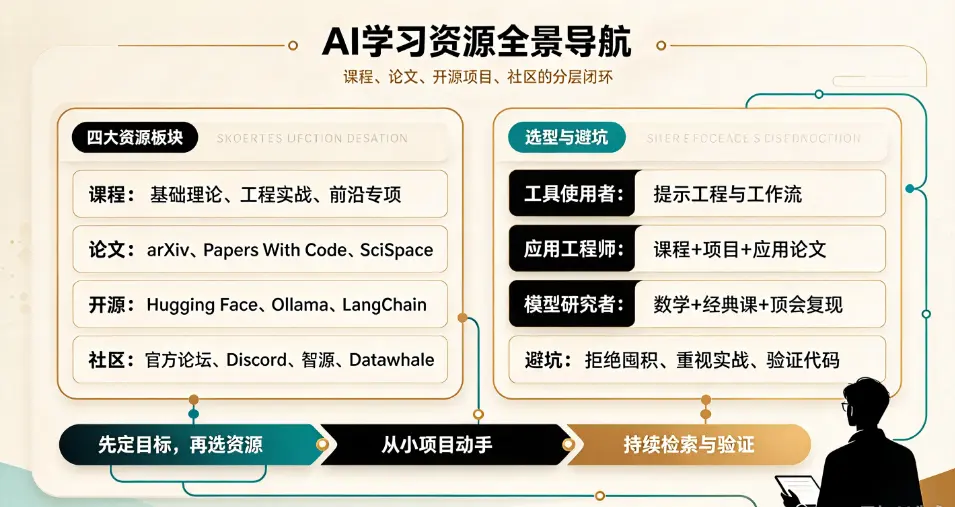
随着大模型、多模态、AI 智能体、SSM/Mamba 等技术持续落地,2026 年 AI 学习的门槛已经发生巨大变化。不同于早年机器学习以数学理论为主,当前 AI 学习分为三个层次:AI 工具使用者、AI 应用工程师、底层模型研究者。但互联网上教程良莠不齐,短视频碎片化内容、过时博客、失效代码大量存在,很多学习者花费大量时间,却无法形成完整知识体系。本文整合全球主流 AI 学习资源,从课程、论文、开源项目、开发者社区四个维度做系统性梳理,同时给出分层学习策略,帮助不同基础的学习者精准匹配资源。
 6bf36845c163c51e91ce83f381b5d50.webp
一、精品在线课程:分层学习,适配零基础到前沿工程
课程是搭建知识底座的核心,2026 年 AI 课程已经明显分化为基础理论课、生成式 AI 工程课、前沿专项课三大类别,学习者可以根据自身目标选择。
零基础入门课程,首选吴恩达 [DeepLearning.AI](DeepLearning.AI) 系列课程。经典《机器学习专项课》持续更新 2026 版本,补充大模型基础、评估与对齐内容,可免费旁听,适合没有机器学习基础的学习者建立基础直觉。哈佛 CS50 AI(CS50AI)是计算机方向优质免费课程,讲解搜索算法、概率、贝叶斯网络、神经网络,配套 Python 实战项目,适合有基础编程能力的学习者,弥补很多大模型速成课缺失的底层计算机知识。[fast.ai](fast.ai)《Practical Deep Learning for Coders》采用 “先做项目,后补理论” 的教学思路,上手即可训练模型,不需要预先掌握复杂数学,适合工程师快速上手深度学习实践。
进阶工程实战课程,聚焦 LLM 应用开发、RAG、Agent 开发,是 2026 年需求量最高的方向。[DeepLearning.AI](DeepLearning.AI) 推出的《Large Language Models for Application Developers》,配套 LangChain、CrewAI 实战案例,讲解工具调用、智能体编排、检索增强生成等工程能力。开源免费课程《AI Engineering from Scratch》拥有 435 课时,覆盖线性代数、模型微调、多智能体集群,全部开源 MIT 协议,适合想要系统性学习 AI 工程的开发者,课程每一节都附带可直接复用的代码工件。
专项前沿课程方面,包含 MoE、状态空间模型、神经符号系统、具身智能,部分课程由斯坦福、MIT 高校开放,部分在 Coursera、edX 上线。同时国内智源社区、Datawhale 持续推出免费组队学习营,覆盖大模型微调、向量数据库、RAG 实战,中文资料友好,适合国内学习者。
课程学习避坑要点:不要一次性报名大量课程。对于应用型学习者,优先学工程实战课程;计划做底层模型研究,必须补齐数学与经典机器学习理论。短视频碎片化教程只能作为辅助,不能替代系统课程。
二、论文检索平台:追踪前沿,快速读懂 AI 最新突破
论文是跟进 AI 前沿技术的核心渠道。2026 年 AI 论文产出量爆炸,每年上万篇论文发布,盲目阅读会消耗大量时间,学习者需要专业平台筛选、复现与阅读辅助工具。
arXiv 仍然是 AI 领域论文首发核心平台,绝大多数大模型、多模态、Agent、SSM 相关论文预印本优先上传于此。Papers With Code 是必备配套工具,将论文、开源代码、评测榜单绑定,能够直接查看论文对应的开源实现、基准测试数据,解决 “读论文找不到代码” 的痛点,2026 年新增 AI 自动摘要功能,一键提炼论文核心贡献、实验设置。
SciSpace 是科研向 AI 论文阅读助手,可检索超过 2.7 亿篇学术文献,支持对话式阅读,自动解析公式、生成文献综述、规范引用格式,大幅降低论文阅读门槛,适合学生和科研人员。LMSYS(大模型系统组织)除了 Chatbot Arena 大模型评测,还持续发布大模型推理、SGLang 服务引擎相关论文,聚焦大模型工程落地,对于做模型部署的开发者极具参考价值。
国内论文资源方面,智源社区、CCF 数字图书馆收录大量国内 AI 顶会解读,提供中文导读,降低英文论文阅读压力。阅读论文的学习策略:新手优先从顶会(NeurIPS、ICML、ICLR、CVPR)经典论文入手,不要直接阅读最新未验证预印本;采用 “先看摘要、实验,再看方法” 的阅读顺序。
三、开源项目仓库:动手实战,把知识转化为工程能力
2026 年 AI 学习的核心原则是 “动手优先”,只听课读论文很难真正掌握能力,开源项目是最佳实战载体。
Hugging Face Hub 是全球 AI 开源模型的核心枢纽,托管超过 250 万模型、数据集、Demo,Transformers、Diffusers、Safetensors 等核心库持续迭代,支持 LLM、多模态、语音模型的加载、微调与推理,是绝大多数 AI 应用开发者的首选平台。国内对应的魔搭 ModelScope、启智 OpenI 社区,提供国内可直接访问的开源模型,配套免费算力资源,适合国内开发者做模型微调、本地部署,降低网络与算力门槛,DeepSeek、通义、MiniCPM 等国产模型在此持续更新。
工程实战类开源项目:OpenAI Cookbook 提供 RAG、Function Calling、多智能体等完整可运行代码案例;LangChain、LlamaIndex、AutoGen 是 Agent 与检索增强生态标杆项目,2026 版本强化多智能体协同、记忆管理、评估工具;Ollama 适合本地快速部署开源大模型,零基础即可在个人电脑运行 7B、14B 模型,适合本地验证原型。
开源项目学习方法:初学者不要直接阅读超大模型源码。优先复刻官方 Demo,从小型项目入手,例如搭建简易 RAG、简单智能体;进阶之后再阅读模型底层代码,尝试 LoRA 微调、模型量化、推理优化。同时重视版本差异,很多旧项目代码已经不兼容 2026 新版框架,优先选择近半年持续维护的仓库。
四、全球 AI 开发者社区:交流、答疑、组队与项目共创
优质社区可以解决自学过程中的卡点,获取行业一线信息,找到项目伙伴,是自学体系不可或缺的一环。
国际社区:Hugging Face 论坛,全球模型开发者交流核心社区,讨论模型微调、数据集、部署问题;Reddit r/MachineLearning、r/LocalLLaMA,前者用于论文讨论,后者专注本地开源大模型部署;Discord 社区中,LangChain、LlamaIndex、Mamba 官方社区,维护者在线答疑,发布新版本预告。
国内优质 AI 社区:智源社区,聚焦前沿 AI 论文解读、技术直播;Datawhale,主打免费组队学习,适合新手共同学习、完成实战项目;魔搭、启智社区,定期举办模型开发大赛、开源共创活动,提供普惠算力支持;GitHub Discussion 板块,几乎所有主流开源项目都在此提供官方答疑。
社区使用注意事项:区分技术讨论和营销内容,很多社群混杂付费课程广告、项目炒作;优先参与官方社区,减少信息噪音;在提问前,先查阅文档、issues,养成良好提问习惯。
五、资源选型策略与学习避坑指南
2026 年很多学习者的误区,是收集海量资源但不落地,囤积大量课程、论文仓库却不实战。资源选择核心逻辑:目标决定资源组合。
普通职场人(AI 工具使用者):优先学习提示工程、AI 工作流课程,搭配官方文档,不需要深入底层论文;
AI 应用工程师(RAG/Agent 开发):课程 + 开源项目为主,选择性阅读应用类论文;
模型底层研究者:数学 + 经典课程 + 顶会论文,复现模型开源代码。
同时需要警惕三类低质资源:单纯搬运、代码无法运行的老旧教程;夸大宣传、收费高昂的 “大模型速成班”;自媒体碎片化解读,缺少实验验证的片面观点。
六、总结
2026 年 AI 学习不再是单一看书听课,而是课程构建理论基础、论文追踪前沿方向、开源项目落地实战、社区解决疑难问题,四者形成完整闭环。全球 AI 资源生态持续蓬勃发展,大量高质量免费资源向公众开放,学习的瓶颈不再是缺少资料,而是缺少筛选能力与持续实战的执行力。
学习者应当根据自身定位,搭建轻量化资源栈,拒绝资源囤积。AI 领域迭代速度极快,学会持续检索、验证、动手实践,远比一次性学完所有知识点更加重要。这套资源导航,为不同阶段学习者提供清晰的检索地图,帮助大家在海量 AI 信息中高效学习,跟上大模型、多模态、AI 智能体的技术浪潮。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

评论列表