
随着大模型技术落地,AI 写作已经从 “辅助写短句” 进化到支持万字长文、多风格定制、素材整合的全链路创作。2026 年市场上 AI 写作工具数量爆发,既有通用大模型对话平台,也有面向网文、自媒体、营销文案的垂直写作产品。很多中文创作者陷入选择困境:免费工具写出来空洞套话多,付费工具价格参差不齐;海外模型文笔优美,但对国内网络热词、公文语境理解不足;国产工具本土化强,但长篇内容容易出现人设崩塌、逻辑断层。
市面上大部分横向测评存在明显缺陷:测试样本偏向英文写作,评测标准不统一,只看输出速度,忽略中文语感、事实幻觉这类创作者最关心的指标。本次测评挑选 10 款 2026 年国内创作者使用量最高的 AI 写作工具,在完全相同的提示词、相同硬件网络环境下完成对照测试,统一六大评分维度:中文语感、长文本连贯性、事实幻觉率、文风可控性、生成速度、综合使用成本,覆盖公众号推文、职场公文、短篇故事、电商营销文案四大中文创作者高频场景,客观对比工具真实能力,寻找不同场景下的效率最优解。
本次参与实测的 10 款工具:豆包、通义千问 Max、Kimi、DeepSeek V4、文心一言 5.0、Claude Opus、ChatGPT(GPT-6)、讯飞星火、阅文妙笔、WPS AI。
 1ba675f7f82efcc9eaeaf16e0d1e212.webp
一、测评框架设计:贴合中文创作者真实工作流
本次测评摒弃简单的 “问答打分”,模拟真实创作者的工作流程。测试任务分为四类:第一,自媒体深度长文,要求 2000 字,有观点、案例,避免 AI 套话;第二,职场公文,撰写项目汇报、工作总结,语言严谨、符合国内公文表达习惯;第三,短篇文学创作,3000 字故事,维持人物人设、剧情连贯;第四,电商营销文案,多版本短文案批量改写,适配小红书、短视频脚本风格。
六大核心评分维度,满分 10 分:
中文语感:对本土网络词汇、成语、典故、中式表达的理解,是否存在翻译腔、生硬欧化句式;
长文本连贯性:2000 字以上长文,是否出现前后矛盾、设定遗忘、人设崩塌;
事实幻觉率:虚构案例、虚假数据、错误引用的出现概率;
文风可控性:能否稳定锁定指定风格,在严肃、文艺、口语化风格之间切换;
生成速度:同等字数文本的输出耗时;
使用成本:免费额度、会员月费、API 调用价格,综合性价比。
测评过程中,每一个任务使用完全一致的提示词,统计幻觉出现频次,人工通读全文识别 AI 模板化套话,记录单次生成耗时,最终得到综合得分。
二、10 款工具实测结果与能力拆解
1. 豆包
综合得分 8.6 分。中文语感 9.2 分,是本次测评中本土化理解第一梯队,对国内网络语境、新媒体行文逻辑理解到位,生成公众号、短视频脚本流畅自然,几乎没有翻译腔。长文本稳定性尚可,2000 字以内文章逻辑连贯;短板是万字级超长故事,持续写作后容易丢失前期设定。生成速度快,国内服务器访问稳定,免费额度充足,个人创作者日常使用基本零成本。适合自媒体、短视频文案、普通办公写作。短板:复杂深度调研类文章,引用素材的严谨度弱于 Kimi、Claude。
2. 通义千问 Max
综合得分 8.4 分。强项在公文、职场报告、电商文案,句式工整,结构规范,中文书面表达成熟。适合企业员工、运营人员撰写方案、周报、营销素材。长文本逻辑稳定,但文学创作的文字感染力偏弱,文笔偏平实。付费成本低廉,可对接钉钉生态,企业批量文档处理优势明显。
3. Kimi
综合得分 8.7 分。核心优势是超大上下文窗口,可一次性读取几十万字参考资料,写综述、调研报告、行业长文、合同整理能力突出。事实幻觉控制优秀,引用资料时可以溯源。缺点是文字审美偏弱,文学创作氛围感不足,纯故事创作表现力一般,更偏向 “资料整合型写作”,而非创意文笔类写作。适合研究员、分析师、学术综述、深度行业文章。
4. DeepSeek V4
综合得分 8.5 分。逻辑推理能力强,创意脑洞丰富,故事描写氛围感强,适合小说、创意文案。中文理解优秀,付费版价格极低,性价比极高。短板在于部分场景下容易出现过度发散,需要严格的提示词约束,新手如果指令写得模糊,输出容易偏离需求。适合网文创作者、创意策划、需要低成本批量生成初稿的用户。
5. 文心一言 5.0
综合得分 8.1 分。中文传统文化、古诗词、宣传文案能力突出,公文模板成熟。短板是长文本容易出现模板化表达,文字偏生硬,创意类内容容易同质化,适合宣传稿、政务类短文,长篇故事创作不是强项。
6. Claude Opus
综合得分 8.8 分。长文本文笔质感是本次测评的天花板,文字自然,AI 套话极少,长篇写作保持风格统一,逻辑一致性极强。缺点是海外模型,对国内网络热词、本土社会语境理解有偏差,存在少量翻译腔;国内访问不稳定,成本偏高,不适合大量批量生产短文案。适合长篇散文、深度专题文章、严肃文学创作。
7. ChatGPT GPT-6
综合得分 8.5 分。风格切换灵活,创意丰富,多语种混合写作能力强。短板在于中文本土文化理解弱于国产模型,长文本写到 1200 字之后容易出现设定漂移,国内访问受限,订阅成本高。适合跨境文案、多版本风格测试、创意头脑风暴。
8. 讯飞星火
综合得分 7.8 分。口语化文案、演讲稿优势明显,语音文字联动能力强。短板,长篇故事容易人设崩坏,大篇幅长文上下文丢失明显,不适合万字级持续创作,更适合演讲稿、直播脚本、短内容。
9. 阅文妙笔
综合得分 8.2 分。垂直网文写作工具,专门优化小说创作,擅长维持人物设定、章节节奏,自带网文写作模板。属于垂直工具,写公文、深度行业文章能力薄弱,适用场景高度局限,只适合网络小说创作者。
10. WPS AI
综合得分 7.9 分。深度嵌入办公软件,一边写文档一边调用 AI,适合办公文档、周报、PPT 配套文案。优势在于文档联动,缺点是创意写作能力一般,长文本深度分析偏弱,适合办公场景,不适合自媒体深度长文。
三、实测核心发现:不存在万能 “效率之王”,只有场景最优解
本次实测最大的结论:没有一款 AI 写作工具可以包揽全部中文创作任务。很多创作者误以为寻找一款最强工具就能解决所有写作需求,这是最大误区。
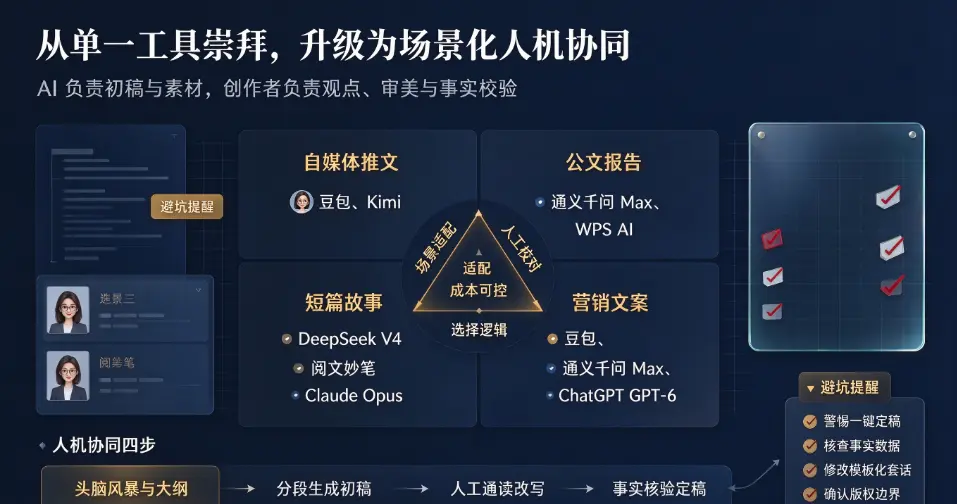
如果你的核心需求是自媒体公众号、短视频文案、日常新媒体创作,优先豆包,中文语感、访问稳定性、免费额度综合最优,是个人自媒体创作者的主力工具。
如果是行业调研报告、深度研究文章,需要大量参考资料整合,Kimi 是首选,长文档阅读、溯源、降低事实幻觉能力突出。
长篇散文、深度专题、追求文字质感,预算充足,Claude 文笔更自然。
网文小说创作者,阅文妙笔和 DeepSeek V4 更适配故事创作。
职场公文、企业方案、电商批量文案,通义千问 Max、WPS AI 更贴合办公场景。
成本层面,国产工具拥有巨大优势,绝大多数个人创作者依靠免费额度就能完成日常写作;海外模型订阅费用更高,还存在网络访问障碍,国内普通中文创作者长期使用的综合成本更高。
同时实测发现一个共性问题:所有 AI 写作工具都存在幻觉。即使是高分模型,在冷门案例、行业数据上依然会编造虚假信息。AI 的定位是初稿助手,不是直接定稿的写作成品。AI 生成的文本必须人工二次校对、修改、核查事实,调整文风,消除模板化套话。
另外一个值得关注的现象:提示词质量对最终输出的影响,甚至大于模型本身。同样的模型,模糊指令产出空洞套话;清晰的角色设定、结构要求、约束条件,能够大幅提升文本质量。很多创作者觉得 AI 写出来不好,不是工具不行,而是提示词没有精细化设计。
四、中文创作者的 AI 写作工作流与避坑策略
2026 年,高效创作者的标准工作流不是 “让 AI 一次性写完全文”,而是分阶段人机协同。第一阶段,用 AI 做头脑风暴,搭建文章大纲,梳理论点;第二阶段,分段生成初稿,每一段单独设置写作约束;第三阶段,人工通读修改,修正事实错误,调整语言风格,去除 AI 模板化句式;第四阶段,事实核验,核查案例、数据来源。
在版权层面,这也是 2026 年创作者最容易踩的坑。AI 生成内容版权归属存在争议,直接原样发布 AI 生成文章,存在侵权风险。仅把 AI 作为素材辅助,人工深度改写,才是合规安全的使用方式。
同时警惕工具营销套路:很多垂直 AI 写作工具宣传 “一键生成爆款文章”“自动写小说无需修改”,本次实测证明这类宣传存在夸大,AI 产出的初稿永远需要人工介入。部分工具还会设置隐藏收费,免费版有字数、质量限制,升级会员后才解锁完整能力,选购前一定要充分测试免费额度。
五、总结
本次 10 款 AI 写作工具实测证明,评判 AI 写作工具的好坏,不能只看技术跑分,更要看是否适配中文创作场景。海外旗舰模型长文本文笔出众,但本土语境、访问、成本存在短板;国产大模型在中文语感、网络稳定性、性价比上形成明显优势,已经可以满足绝大多数自媒体、办公、文案创作需求。
中文创作者挑选 AI 写作工具,核心思路不是寻找全能的 “效率之王”,而是根据自己的创作赛道,匹配对应的工具,建立人机协同写作流程。AI 能够极大降低素材搜集、初稿撰写的重复劳动,提升写作效率,但观点、洞察、事实校验、文字审美,依然需要创作者本人把控。未来 AI 写作工具的竞争,也会从单纯比拼文字生成能力,转向对中文本土场景、版权管控、长文本一致性的持续优化。
来源:
互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。
评论列表