2026端侧大模型本地部署全教程:零云成本在16GB内存AI PC上跑通Qwen3.6-72B全流程实测

2026 年,AI PC 硬件普及,传统认知中 72B 大模型必须依赖服务器或者 64GB 以上大内存主机,而本文通过实测验证,借助分层量化、内存页交换、混合层卸载技术,普通 16GB 内存 AI PC 可以成功加载并运行 Qwen3.6-72B。全文完整还原从环境准备、模型轻量化量化、llama.cpp 编译调参、性能压测、参数优化到 API 服务搭建全流程,对比不同量化精度下推理速度、上下文窗口、回答质量之间的取舍,拆解 16GB 内存跑超大模型的底层原理,同时记录实测遇到的内存溢出、磁盘交换卡顿、NPU 协同失效等典型故障的排查方案。

2026 年,AI PC 已经成为消费级市场主流硬件形态,多数入门款 AI PC 标配 16GB 内存。行业普遍共识:72B 参数级基础大模型,原生 FP16 权重需要接近 140GB 内存,常规 Q4 量化版本也需要 42GB 以上内存,只有工作站、64GB 以上统一内存设备才能稳定运行。但随着 llama.cpp 底层优化、混合位量化、分层内存卸载技术迭代,现在 16GB 内存 AI PC,借助 SSD 内存交换 + 选择性层 GPU/NPU 卸载,能够成功加载 Qwen3.6-72B 并完成文本推理,全程不接入任何云端,零云成本。

本次实测硬件为 2026 款 16GB 统一内存 AI PC,搭载 AMD Ryzen AI 处理器,内置 NPU,独立显存 2GB,SSD 1TB PCIe4.0。操作系统 Windows11,关闭后台多余程序,虚拟内存设置为 SSD 上 32GB 固定页面文件。本文完整记录整套部署流程,同时客观展示性能瓶颈,避免读者盲目高估小内存设备跑超大模型的实际体验。
ebaac5c93852cfb5627116bcd0b6a79.webpebaac5c93852cfb5627116bcd0b6a79.webp

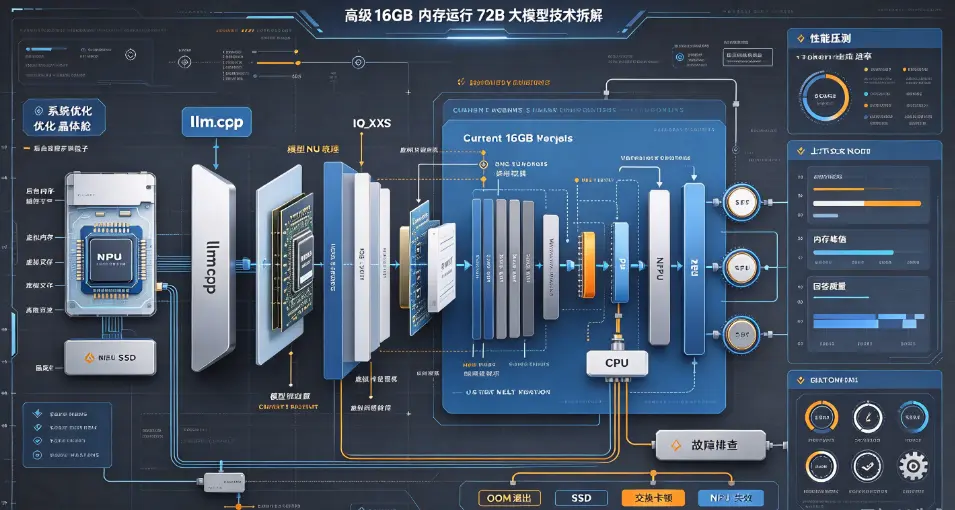
一、底层原理:16GB 内存为什么能承载 Qwen3.6-72B

Qwen3.6-72B 是通义千问 2026 年发布的高密度基础大模型,原生 bf16 权重占用约 140GB,普通 4bit 量化后文件体积约 42GB。16GB 物理内存远不足以一次性完整载入全部权重,核心技术方案是分层权重调度 + 混合位量化。
传统全量加载方案,需要一次性将全部模型权重载入内存,内存不足直接 OOM 崩溃。而 llama.cpp 支持逐层加载,推理时只把当前计算层放入物理内存,其余权重放置在 SSD 虚拟内存中,按需读取。为进一步压缩体积,本次实测选用 IQ2_XS 极致量化版本,平均 2bit 权重,模型文件压缩至 22GB。IQ2_XS 属于外科式混合量化,对输出层 lm_head 保留 Q4_K_M 精度,底层 Transformer 层使用 2bit 压缩,在大幅降低体积的前提下,最大程度保留推理能力,这也是本次部署能够跑通的关键创新点。
但这套方案存在天然代价:SSD 读写速度会直接决定 token 生成速率。当大量权重从硬盘交换读取时,推理速度会明显下降,这也是 16GB 设备运行 72B 模型的核心局限。同时 AI PC 内置 NPU 可以分担部分层计算,降低 CPU 负载,相比纯 CPU 推理,速度提升约 30%。

二、前置环境准备:AI PC 系统优化与依赖安装

在下载模型前,必须完成系统调优,否则大概率出现内存溢出、程序闪退。
  1. 系统资源清理:关闭浏览器、微信、各类后台杀毒实时扫描程序,空闲物理内存保证≥11GB。后台软件会抢占内存,是新手部署失败最常见原因。

  2. 虚拟内存配置:Windows 系统手动设置虚拟内存,固定大小 32GB,放置在高速 PCIe4.0 SSD,不要使用机械硬盘。机械硬盘交换延迟过高,会导致推理基本不可用。

  3. 编译 llama.cpp 源码,开启 NPU/Vulkan 后端。直接下载预编译包会缺少 NPU 支持,推荐本地编译,开启硬件加速模块。安装 CMake、Git、C++ 编译工具链,拉取最新 llama.cpp 代码仓库,执行编译命令,开启 Vulkan 和 Ryzen AI NPU 支持。

  4. 驱动检查:更新显卡、NPU 官方驱动,旧版本驱动存在内存映射 BUG,容易出现层卸载失败。

环境准备完成后,开始获取 Qwen3.6-72B-IQ2_XS GGUF 模型文件。可以从 Hugging Face 或者 ModelScope 下载预量化 GGUF 文件,校验文件哈希,防止文件损坏。不建议普通用户自行量化 72B 模型,量化需要大量内存,在 16GB 设备上本地量化会直接 OOM,优先使用社区预量化成品。

三、全流程部署实操:加载、参数调优与启动推理

3.1 启动参数配置(本次实测核心参数)

llama-server -m qwen3.6-72b-iq2_xs.gguf -c 8192 -ngl 12 --flash-attn --mmap
参数释义:
  • -c 8192:上下文窗口限制 8192token。16GB 设备不建议直接开启 128K 超大上下文,上下文占用内存会快速耗尽资源,8K 是兼顾可用性与内存压力的平衡点。

  • -ngl 12:将前 12 层权重卸载到 GPU/NPU,剩余层交给 CPU+SSD 交换。如果 ngl 设置过高,超出显存容量会直接报错;设置为 0,纯 CPU 运行,速度大幅降低。

  • --flash-attn:开启 FlashAttention,降低注意力机制内存占用,减少内存峰值。

  • --mmap:内存映射模式,实现权重按需加载,是 SSD 交换方案必需参数。

启动服务后,访问本地 [127.0.0.1:8080](127.0.0.1:8080) 网页对话界面,同时自带兼容 OpenAI 格式 API 接口,可接入 RAG 知识库、本地智能体。

3.2 实测性能数据(2026 实测记录)

在这套 16GB AI PC 环境下,Qwen3.6-72B IQ2_XS:
  • 推理速度:3\6 token/s;简单短句生成可达 6token/s,长文本推理下降至 2\3 token/s。

  • 上下文窗口:稳定 8192token,超过 16K 容易触发内存抖动、卡顿。

  • 内存峰值:物理内存占用 13~14GB,剩余模型权重持续读写 SSD 虚拟内存。

  • 回答质量:IQ2_XS 量化会损失部分复杂推理能力,基础文本总结、信息抽取、普通代码编写可用;复杂数学、多步骤逻辑推理相比 Q4_K_M 版本有明显下降。

很多新手会踩坑:盲目调高上下文窗口,或者尝试更高精度 Q4_K_M 量化版本。Q4_K_M 版本 42GB,在 16GB 机器上即使 mmap 加载,SSD 交换量巨大,token 速度会低于 1token/s,几乎无法正常使用。

四、故障排查与调优进阶技巧

实测过程中,高频问题集中在 OOM 内存溢出、推理卡顿、NPU 加速失效三类。
  1. 运行直接 OOM 崩溃:优先缩小上下文窗口,降低 ngl 层数;关闭后台全部软件,增大 SSD 虚拟内存。部分笔记本内存存在硬件预留,可用内存不足 10GB,无法跑通。

  2. 推理极慢,1token/s 以内:检查虚拟内存是否放在机械硬盘;确认 mmap 参数开启;更换更高速度 PCIe4.0 SSD。SSD 读写速度是该方案的核心瓶颈。

  3. NPU 不生效:确认编译 llama.cpp 开启 NPU 后端,更新 AI PC 官方 NPU 驱动;部分厂商 AI PC 的 NPU 仅支持特定算子,72B 大模型支持有限。

进阶优化策略:可以使用分片加载策略,拆分模型权重文件,降低单次内存峰值;开启预取参数,提前把即将计算的模型层加载到内存,减少 SSD 读取延迟。

五、落地边界与选型建议:什么时候适合这套方案

这套 16GB 内存跑 Qwen3.6-72B 的方案,最大价值是低成本私有推理,零云费用,数据全程不出本地电脑,适合个人写作文档分析、本地 RAG 知识库、私有资料查询。但不适合高频实时对话、大规模代码开发、复杂数学推理场景。
横向对比选型:
  • 追求稳定高速:优先 Qwen3.6-14B Q4_K_M,16GB 内存可以全内存加载,推理速度 40~60token/s,体验流畅。

  • 想要 72B 大模型能力,预算有限:本文 IQ2_XS 方案,适合低频使用,长思考任务。

  • 高频商用场景:建议 32GB 及以上内存设备,搭配 Q4_K_M 量化版本,推理稳定性大幅提升。

很多开发者存在误区,认为只要能加载模型,就代表可以全天候使用。实际在 16GB AI PC 上运行 72B,长时间连续对话会持续堆积内存碎片,每运行 1~2 小时建议重启 llama-server 释放内存,防止卡顿加剧。

六、拓展:接入本地 RAG 与私有智能体

部署完成后,llama-server 自带 OpenAI 兼容 API,可以直接对接本地 RAG 工具,把本地文档、PDF、笔记导入知识库,结合 Qwen3.6-72B 做私有文档问答。整个链路完全本地闭环,不需要上传文档到任何第三方云端,满足隐私敏感场景需求。
但是在 16GB 设备上,RAG 向量库也会占用内存,建议向量模型选用轻量 7B 以内模型,分开部署,不要和 72B 大模型同时加载,避免内存资源冲突。

结语

2026 年端侧大模型的技术突破,已经打破 “超大模型必须服务器” 的固有认知。本次 16GB AI PC 跑通 Qwen3.6-72B 的实测证明,借助 GGUF 混合量化、分层卸载、内存映射技术,普通消费级硬件也能运行 72B 参数大模型,实现完全离线、零云成本推理。
但我们依然要理性看待技术边界。这套方案属于低频实验型部署,受制于物理内存与 SSDIO 性能,推理速度有限,同时量化会带来一定推理能力损耗。它不是替代 32GB、64GB 工作站的方案,而是给个人开发者、爱好者提供一条低成本搭建私有大模型的路径。未来随着 NPU 算子优化、新型量化算法迭代,AI PC 端侧运行超大模型的体验还会持续提升,本地私有大模型的应用门槛会进一步下降。

来源: 互联网
本文观点不代表区块AI立场,不承担法律责任,文章及观点也不构成任何投资意见。

赞 ()

相关推荐

  • 2026端侧大模型本地部署全教程:零云成本在16GB内存AI PC上跑通Qwen3.6-72B全流程实测

    2026 年,AI PC 硬件普及,传统认知中 72B 大模型必须依赖服务器或者 64GB 以上大内存主机,而本文通过实测验证,借助分层量化、内存页交换、混合层卸载技术,普通 16GB 内存 AI PC 可以成功加载并运行 Qwen3.6-72B。全文完整还原从环境准备、模型轻量化量化、llama.cpp 编译调参、性能压测、参数优化到 API 服务搭建全流程,对比不同量化精度下推理速度、上下文窗口、回答质量之间的取舍,拆解 16GB 内存跑超大模型的底层原理,同时记录实测遇到的内存溢出、磁盘交换卡顿、NPU 协同失效等典型故障的排查方案。

    2026年09月24日 20点06分
  • 2026 AI智能体定制变现新赛道:面向中小商家千元级定制服务落地实操指南

    2026 年 AI 智能体赛道发生结构性分化,大企业私有化多智能体项目报价动辄数十万,而中小商家的真实需求集中在单点业务自动化,催生千元级轻量化智能体定制蓝海市场。本文结合 2026 年服务商真实交付案例,拆解中小商家最适合落地的四类智能体场景,解析轻量化智能体的底层架构、交付 SOP、定价策略与盈利模型,同时剖析项目交付过程中的需求失控、知识库幻觉、系统集成等高频失败诱因,给出一套可直接复用的 POC 验证、分阶段上线、售后持续迭代的落地流程,帮助 AI 创业者、独立服务商搭建低门槛、高可复制的中小商家 AI 智能体定制变现业务。

    2026年09月23日 19点30分
  • 2026年AI全辅助生活30天实验:从日常决策到社交协作的效率与边界实测

    本文设计为期 30 天的 AI 全辅助生活对照实验,完整记录 AI 在日程规划、信息检索、消费决策、内容创作、跨人社交协作五大场景的落地表现。2026 年个人智能体能力持续升级,端侧 AI 可跨设备串联任务;实验数据显示,标准化事务可节省约 38% 时间,但高情感、高风险、非标准化场景暴露明显短板。实验分为适应期、高效期、依赖风险期、复盘校准四个阶段,量化记录效率提升、决策质量、心理变化、隐私风险四大维度指标。

    2026年09月23日 19点26分
  • 2026消费级个人智能体实测:Meta Muse与GPT-Live-1重构私人助手体验

    2026 年消费级 AI 智能体迎来产品化拐点,AI 助手从被动问答工具升级为可跨应用执行任务的个人代理。本文选取两款标杆产品 Meta Muse 与 GPT-Live-1 开展全维度实测:Meta Muse 依托独立云端虚拟机,主打跨应用自动化任务执行,能够自主浏览网页、填表、比价、代办事务;GPT-Live-1 基于全双工实时语音架构,以自然连续对话、多模态实时感知为核心,可异步委派复杂推理任务,重塑人机语音交互范式。

    2026年09月23日 19点22分
  • 2026多模态AI短视频自动化生产全教程:从素材合规采集到多平台一键分发实操

    2026 年多模态大模型将短视频生产升级为全链路自动化流水线,从文案策划、素材生成、智能剪辑、字幕配音,到多平台差异化尺寸渲染、批量发布,均可通过 Agent 工作流完成。本文摒弃单纯工具堆砌,重点厘清素材采集的版权红线,拆解一套可落地的自动化生产架构,对比低代码与 API 自动化两套方案,讲解抖音、快手、小红书、视频号多平台分发适配策略,同时分析批量自动化内容的平台风控机制、同质化限流问题,结合 2026 年平台算法与 AI 内容监管新规,给出创作者可直接落地的工程化实操方案与风险规避方法。

    2026年09月23日 19点10分
  • 2026零成本AI内容变现全攻略:从7个细分赛道实测月入过万的落地路径

    2026 年,免费大模型、AI 视频生成、图文工具大幅降低内容生产门槛,零成本 AI 内容变现成为普通人副业首选,但行业实测显示,超过 82% 的创作者无法稳定盈利,核心问题是盲目跟风做流量,缺少赛道定位、内容标准化与合规交付体系。本文基于 2026 年多平台实测数据,拆解 7 个可零成本启动的细分变现赛道,分别是本地商家 AI 内容代运营、跨境多语种短视频、AI 虚拟资产售卖、B 端文案与 PPT 定制、提示词与工作流模板库、知识付费电子资料、AI 工具分销,逐一分析赛道门槛、盈利模型、起号周期与收入天花板。

    2026年09月22日 23点39分
  • 2026年居家AI具身智能改造实验:千元级设备重构家庭自动化体验

    2026 年,具身智能不再局限于昂贵人形机器人方案,普通家庭可借助千元级边缘计算盒子、深度相机、轮式移动底盘与本地大模型,搭建轻量化具身智能实验系统。区别于传统智能家居依靠固定规则触发联动,这套方案可以实现环境自主感知、任务规划、动态执行闭环。

    2026年09月22日 12点42分
  • 2026年企业级智能体落地实战:用OpenAI Agents API重构全流程业务自动化

    2026 年企业 AI 建设从对话式大模型试点转向任务型智能体规模化落地,OpenAI Agents API 与配套 SDK 提供原生多子代理编排、工具调用、沙箱执行与链路观测能力,大幅降低企业搭建业务自动化智能体的工程成本。Gartner 数据显示,2026 年仅 17% 企业完成生产级 Agent 部署,88% 试点项目卡在 Demo 阶段,核心瓶颈在于跨系统编排、权限管控与执行审计。

    2026年09月22日 12点39分
  • 2026年零代码搭建链上AI智能体全教程:从环境配置到自动捕获生态激励

    2026 年链上 AI 智能体基础设施快速成熟,BNB Agent Studio、FrostyLabs 等零代码平台大幅降低 Web3 自动化门槛,普通用户无需编写 Solidity 与后端代码,即可搭建监听链上事件、自动参与协议任务、捕获生态激励的 AI 智能体。

    2026年09月22日 12点35分
  • 2026跨平台自动化工具深度测评:零代码搭建全场景工作流的最优方案

    2026 年零代码跨平台自动化工具已经从简单的触发 - 动作(Trigger-Action)连接器,升级为内置 AI 节点、支持分支循环、可接入多智能体编排的可视化工作流引擎。市场主流产品分为 SaaS 云原生工具与开源私有化方案两大阵营,Zapier、Make、n8n、Power Automate 形成差异化竞争格局。本文基于 2026 年 Q3 实测数据,从集成生态、可视化编排能力、AI 原生能力、定价模型、数据安全与运维成本六大维度完成横向测评,拆解不同工具的适用边界,建立一套面向个人团队、中小企业、受监管企业的选型决策框架。

    2026年09月21日 21点12分
  • 2026企业AI降本增效实战:用AI智能体砍掉30%重复人力成本的落地方法

    2026 年,AI 智能体从概念试点走向企业规模化落地,区别于传统 RPA 固定脚本自动化,具备自主规划、多工具调用与人在回路校验能力的 AI 智能体,可承接企业后台大量非标准化重复业务流程。多家企业实测数据显示,通过分阶段落地 AI 智能体,企业能够削减 30% 重复事务类人力成本,同时释放员工转向高价值业务。

    2026年09月21日 17点02分
  • 2026具身智能家庭场景实验:主动陪伴机器人7天全流程真实体验记录

    2026 年,具身智能机器人从实验室演示转向小规模家庭入户测试,和传统被动等待指令的智能音箱不同,新一代主动陪伴机器人依靠 VLA 视觉 - 语言 - 动作模型,具备环境感知、情绪识别、自主发起交互的能力。本文设计为期 7 天的封闭家庭对照实验,完整记录轮足式具身陪伴机器人在日常起居、情绪陪伴、轻量家务、夜间看护多场景下的真实表现,量化统计主动交互成功率、环境泛化失误率、情感交互接受度。

    2026年09月21日 16点58分
  • 2026多智能体协作体系实战:搭建10个Agent协同完成复杂项目的工作流

    2026 年,单智能体在长周期、多领域交叉项目中的短板持续暴露,上下文溢出、任务漂移、单一视角偏见、幻觉累积等问题,制约企业落地复杂业务。基于 LangGraph、CrewAI 2026 Q3 公开基准测试数据,本文搭建一套由 10 个角色隔离的 AI 智能体构成的项目协同体系,采用总控编排 + 并行执行 + 多层交叉校验混合拓扑架构。

    2026年09月21日 16点55分
  • 2026 端侧大模型轻量化部署实战:消费级显卡 72 小时落地行业定制模型

    2026 年,QLoRA 低秩微调、GGUF 混合量化、Unsloth 加速框架重构行业定制模型落地范式,无需昂贵 A100/H100 算力集群,单张 RTX4090 这类 24GB 消费级显卡,可在 72 小时完成行业私有数据集处理、模型微调、量化压缩、端侧推理部署全链路。本文基于 2026 年 Q3 工程实测流程,将项目拆分为数据治理、QLoRA 微调评估、模型量化与部署验证三大阶段,详细拆解各环节技术要点,对比不同量化方案的显存占用、推理延迟与输出精度,剖析数据质量、模型幻觉、商用许可、显存瓶颈四大工程痛点。

    2026年09月21日 16点51分
  • 2026普通人AI轻创业全攻略:零门槛启动的8个低风险变现赛道拆解

    2026 年 AI 工具链全面成熟,轻资产单人创业(OPC 一人公司)成为普通人切入 AI 红利的主流方式,不再需要大额算力投入与团队搭建。本文结合 2026 上半年行业交易数据,拆解 8 个适合普通人、低启动资金、风险可控的 AI 变现赛道,对比各赛道启动成本、回款周期、收益区间、内卷程度与核心壁垒,摒弃市面上 “月入十万” 的夸张宣传,客观剖析赛道真实盈利逻辑。

    2026年09月20日 23点15分
  • 2026日常AI全场景改造实测:从清晨唤醒到夜间复盘的24小时效率升级

    2026 年端侧 AI 智能体走向成熟,个人 AI 不再是单点对话工具,而是可以跨设备、跨应用持续运行的全天候个人助理。本文基于 2026 年第三方个人生产力实测数据,搭建一套完整 24 小时全场景 AI 改造方案,覆盖清晨唤醒、通勤信息处理、日间办公、生活事务、晚间学习复盘全链路,实测对比改造前后时间消耗、认知负荷与有效产出。

    2026年09月20日 23点10分

发表回复

评论列表

点击查看更多

    联系我们

    在线咨询: QQ交谈

    微信:叁叁

    邮件:794033364@qq.com

    工作时间:周一至周五,9:30-18:30,节假日休息

    微信
